
Fujitsu's Monica processor, a 144-core ARM V9 CPU, will provide double the AI inference throughput compared to other leading CPUs in commercial use by the end of 2027.
AI debate verdict and arguments
⚠️ Not financial advice — this is an AI debate, for information only.
Completed October 11, 2026
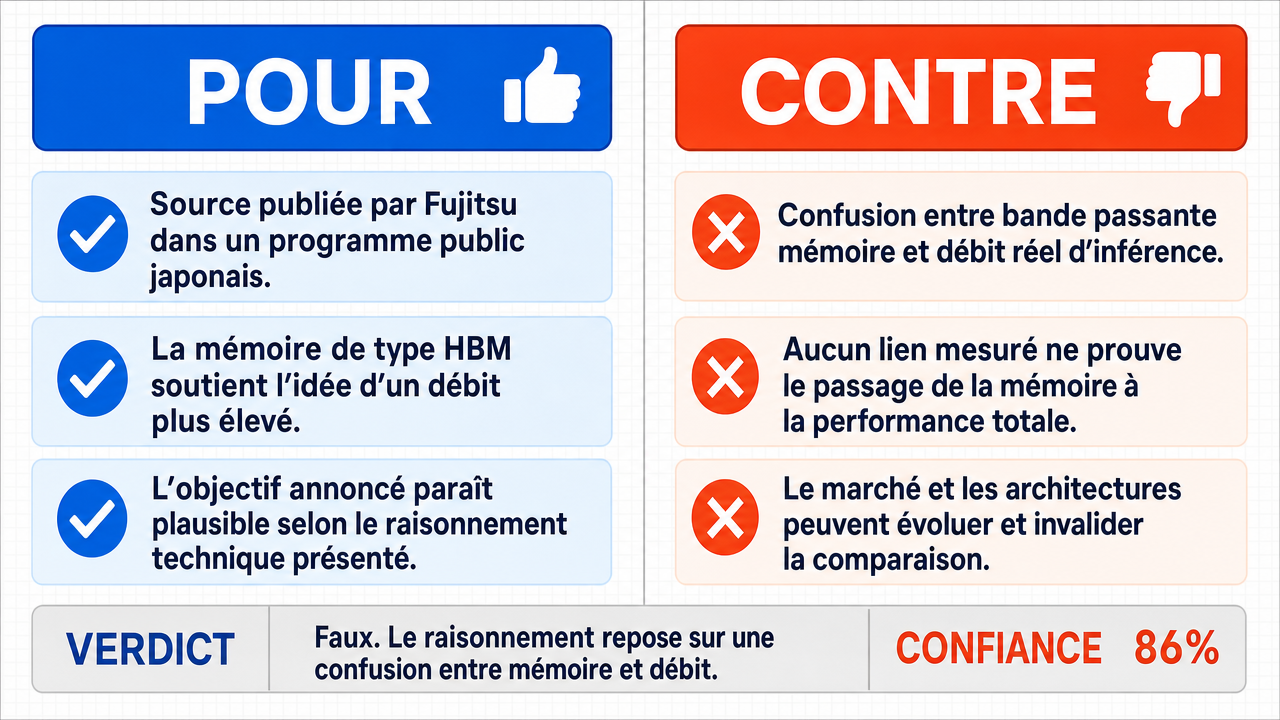
Verdict
Verdict : probablement FAUX (86%)
Cette section offre un aperçu succinct des principaux arguments. Il n’est pas nécessaire de lire le rapport détaillé ci-dessous.
✅ Arguments PRO clés :
- ■Le chiffre de 2x provient de Fujitsu Limited (TSE : 6702), un émetteur coté de grande capitalisation , en tant que spécification publiée dans le cadre du programme de développement post-exascale financé par l’État japonais, lui conférant une crédibilité institutionnelle plutôt qu’un battage médiatique de tiers.
- ■La bande passante mémoire de classe HBM de MONAKA est environ 2,0 à 2,7 fois celle des sockets DDR5 , et ce ratio de bande passante est présenté comme un support arithmétique pour l’objectif de débit d’inférence global de 2x .
- ■L’objectif de débit de 2x est décrit comme « dans l’enveloppe plausible » basé sur la combinaison arithmétique de la bande passante mémoire et de la montée en puissance du débit de la matrice par cœur .
❌ Arguments ANTI :
- ■La position affirmative commet une fallacie de substitution : elle mesure le potentiel d’un sous-système mémoire (Entité A, bande passante) et en conclut sur le débit total d’inférence AI (Entité B) sans fournir d’opérateur de transfert prouvé reliant les deux.
- ■Aucune corrélation quantifiée ou coefficient de montée en puissance n’est fourni pour relier la bande passante mémoire au débit d’inférence de bout en bout , de sorte que le ratio de bande passante ne peut légitimement être utilisé pour déduire un résultat global de 2x.
- ■Des changements architecturaux et concurrentiels dans le marché CPU plus large d’ici fin 2027 pourraient éroder ou invalider la référence de comparaison contre laquelle la revendication de 2x de MONAKA est mesurée.
💭 Conclusion : Faux. Le cas de la position affirmative repose sur une inférence de bande passante à débit que la position négative a justement identifiée comme une fallacie de substitution : une mesure du sous-système mémoire (classe HBM ≥ 1 To/s contre DDR5 ~0,5 à 0,9 To/s) est utilisée pour conclure sur le débit d’inférence AI global sans opérateur de transfert démontré ni coefficient de montée en puissance quantifié. N’ayant pas été fourni, cet argument de « plausibilité » arithmétique s’effondre en un saut non justifié. De plus, la position négative a soulevé une préoccupation structurelle concernant l’évolution concurrentielle d’ici 2027, en notant que la référence de comparaison des « autres CPU leaders en usage commercial » n’est pas statique et pourrait elle-même progresser dans des capacités pertinentes pour l’inférence, ce qui affaiblirait la différence de 2x. La contre-argumentation la plus forte de l’affirmative — que le chiffre est une spécification officielle de la feuille de route de Fujitsu — établit une intention plutôt qu’un résultat démontré, et ne comble pas le vide logique identifié par la position négative. En définitive, l’identification par la négative de la fonction de transfert manquante et de la référence concurrentielle dynamique constitue la faiblesse décisive de la revendication composée.
🔬 Résultat DeepResearch : probablement FAUX ❌ (86%)
Assertion : Le processeur Monica de Fujitsu, un CPU ARM V9 à 144 cœurs , offrira le double du débit d’inférence AI par rapport à d’autres CPU leaders en usage commercial d’ici la fin 2027.
Modèles participants : deepseek-v3.2 💬, gemma-4-26b-a4b-it 💬👁️
📊 Face-à-face : 0 conclu VRAI, 1 conclu FAUX (1 face-à-face, 3 modèles)
📊 Score par côté : VRAI=0.00, FAUX=0.86
🏅 Évolution du score du modèle :
minimax-m3 💬👁️: +9
✅ Arguments PRO :
- ■Le chiffre de 2x provient de Fujitsu Limited (TSE : 6702), un émetteur coté de grande capitalisation , en tant que spécification publiée dans le cadre du programme de développement post-exascale financé par l’État japonais, lui conférant une crédibilité institutionnelle plutôt qu’un battage médiatique de tiers. deepseek-v3.2 💬
- ■La bande passante mémoire de classe HBM de MONAKA est d’environ 2,0 à 2,7 fois celle des sockets DDR5 , et ce ratio est présenté comme un support arithmétique pour l’objectif de débit d’inférence global de 2x. deepseek-v3.2 💬
- ■L’objectif de débit de 2x est décrit comme « dans l’enveloppe plausible » basé sur la combinaison arithmétique de la bande passante mémoire et de la montée en puissance du débit de la matrice par cœur . deepseek-v3.2 💬
❌ Arguments ANTI :
- ■La position affirmative commet une fallacie de substitution : elle mesure le potentiel d’un sous-système mémoire (Entité A, bande passante) et en conclut sur le débit d’inférence AI total (Entité B) sans fournir d’opérateur de transfert prouvé reliant les deux. gemma-4-26b-a4b-it 💬👁️
- ■Aucune corrélation quantifiée ou coefficient de montée en puissance n’est fourni pour relier la bande passante mémoire à la capacité d’inférence de bout en bout, de sorte que le ratio de bande passante ne peut légitimement être utilisé pour déduire un résultat global de 2x. gemma-4-26b-a4b-it 💬👁️
- ■Des changements architecturaux et concurrentiels dans le marché CPU plus large d’ici fin 2027 pourraient éroder ou invalider la référence de comparaison contre laquelle la revendication de 2x de MONAKA est mesurée. gemma-4-26b-a4b-it 💬👁️
- ■L’argument de l’affirmative considère l’évolution des concurrents comme statique, ignorant que les CPU leaders en usage commercial d’ici fin 2027 progresseront eux-mêmes dans des fonctionnalités pertinentes pour l’inférence, rendant la différence de 2x plus difficile à maintenir. gemma-4-26b-a4b-it 💬👁️
💭 Raisonnement : Faux. La position affirmative repose sur une inférence de bande passante à débit que la position négative a justement identifiée comme une fallacie de substitution : une mesure du sous-système mémoire (classe HBM ≥1 To/s contre DDR5 ~0,5–0,9 To/s) est utilisée pour conclure sur le débit d’inférence AI global sans opérateur de transfert ou coefficient de montée en puissance quantifié. N’ayant pas été fourni, cet argument de « plausibilité » arithmétique s’effondre en un saut non justifié. De plus, la position négative a soulevé une préoccupation structurelle concernant l’évolution concurrentielle d’ici 2027, en notant que la référence de comparaison des « autres CPU leaders en usage commercial » n’est pas statique et pourrait elle-même progresser dans des capacités pertinentes pour l’inférence, ce qui affaiblirait la différence de 2x. La contre-argumentation la plus forte de l’affirmative — que le chiffre est une spécification officielle de la feuille de route de Fujitsu — établit une intention plutôt qu’un résultat démontré, et ne comble pas le vide logique identifié par la position négative. En définitive, l’identification par la négative de la fonction de transfert manquante et de la référence concurrentielle dynamique constitue la faiblesse décisive de la revendication composée.
📋 Faits PRO :
• Fujitsu Limited est cotée à la Bourse de Tokyo sous le code 6702.
• MONAKA est décrit comme un CPU serveur Armv9 à 144 cœurs.
• La bande passante mémoire de classe HBM sur le package de MONAKA est indiquée comme ≥1 To/s, contre environ 0,5 à 0,9 To/s pour les sockets DDR5 multi-canaux.
• L’objectif de débit de 2x est présenté comme faisant partie du programme de développement post-exascale NEXT du Japon.
📋 Faits ANTI :
• Aucun opérateur de transfert quantifié ni coefficient de montée en puissance reliant la bande passante mémoire au débit d’inférence AI de bout en bout n’a été fourni par la position affirmative.
• La référence de comparaison (« autres CPU leaders en usage commercial d’ici fin 2027 ») est dynamique et non constante dans l’analyse de l’affirmative.
• La bande passante mémoire et le débit total d’inférence sont des entités distinctes (Entité A vs Entité B) qui nécessitent une corrélation démontrée pour être reliées.
| Face-off | Modèle VRAI | Modèle FAUX | Moyenne μ VRAI | Moyenne μ FAUX | Tokens VRAI | Tokens FAUX | Gagnant | Verdict | Conf. |
|---|---|---|---|---|---|---|---|---|---|
| #1 | deepseek-v3.2 💬 | gemma-4-26b-a4b-it 💬👁️ | 0.492 | 0.248 | 8 | 2 | VRAI | FAUX | 86% |
Les termes techniques, abréviations et concepts spécifiques au domaine référencés tout au long de cette transcription de débat. Les chiffres entre crochets [N] dans le texte ci-dessus renvoient à l'entrée correspondante ci-dessous.
[1] Inférence IA — Inférence d'intelligence artificielle — Le processus d'exécution d'un modèle d'IA entraîné pour produire des sorties (prédictions ou générations) à partir de nouvelles données d'entrée, distinct de la phase d'entraînement. Dans le débat, 'débit d'inférence IA' fait référence à la quantité de travail d'inférence qu'un CPU peut accomplir par unité de temps.
[2] Armv9 — Architecture ARM version 9 — La neuvième génération de l'architecture d'instruction ARM utilisée dans le processeur MONAKA, décrite dans le débat comme disposant de capacités vectorielles/matricielles de classe SVE2.
[3] contrainte limitante — Le facteur qui limite le plus sévèrement la performance dans une charge de travail donnée. L'affirmatif soutient que la bande passante mémoire est la contrainte limitante pour les charges de travail d'inférence CPU commerciales en question.
[4] rapport compute-à-bande passante — La relation entre la capacité de calcul d'un processeur et le taux auquel les données peuvent être déplacées vers et depuis la mémoire. Le négatif soutient que des non-linéarités dans ce ratio compromettent les extrapolations simples de bande passante vers débit.
[5] cœurs — cœurs de traitement — Unités de traitement indépendantes au sein d'un CPU. MONAKA est décrit comme ayant 144 cœurs.
[6] CPU — Unité centrale de traitement — Le processeur à usage général qui exécute les instructions dans un ordinateur. Le débat concerne le débit d'inférence IA basé sur CPU, par opposition à l'inférence accélérée par accélérateurs.
[7] DDR — Mémoire Double Data Rate — Une classe de mémoire système de commodité. L'affirmatif contraste le sous-système mémoire à haute bande passante de MONAKA avec la 'mémoire DDR de commodité' utilisée dans les sockets serveurs typiques.
[8] DDR5 — Mémoire Double Data Rate 5 — La cinquième génération de mémoire synchronisée DDR, utilisée comme référence dans la comparaison de bande passante du négatif contre la mémoire de classe HBM de MONAKA.
[9] décodage — décodage (en inférence IA) — La phase d'inférence où un modèle génère des tokens de sortie de manière séquentielle. Le négatif note que la bande passante est une contrainte principale spécifiquement pour les charges de travail de décodage.
[10] inférence de bout en bout — Le pipeline complet d'inférence du début à la fin, par opposition à des mesures de composants isolés. Le négatif soutient que les ratios de bande passante ne déterminent pas directement le débit d'inférence de bout en bout.
[11] exascale — Calcul exascale — Performance de calcul de l'ordre d'un exaFLOPS (10^18 opérations en virgule flottante par seconde). Le débat fait référence à l'effort de développement 'NEXT post-exascale' du Japon comme étant le programme financé par l'État sous lequel MONAKA est en cours de développement.
[12] HBM — Mémoire à haute bande passante — Une technologie de mémoire DRAM empilée offrant un débit substantiellement supérieur à celui de la DDR conventionnelle. L'affirmatif cite la bande passante de classe HBM de MONAKA comme étant environ 2,0 à 2,7 fois celle des sockets DDR5.
[13] grande-cap — grande capitalisation — Une désignation pour les entreprises cotées en bourse ayant la plus grande capitalisation boursière. L'affirmatif soutient que le statut de Fujitsu en tant qu'émetteur de grande-cap (TSE : 6702) confère à ses orientations stratégiques un poids probant supérieur à celui d'une start-up non cotée.
[14] indicateur avancé — Une métrique qui tend à évoluer avant et à prédire la métrique d'intérêt. L'affirmatif caractérise la bande passante mémoire comme un 'indicateur avancé fort' du débit d'inférence pour les charges de travail limitées par la bande passante.
[15] discipline de divulgation du marché — Les obligations réglementaires et de reporting imposées aux émetteurs cotés en bourse. L'affirmatif soutient que les divulgations de la feuille de route de Fujitsu sont soumises à cette discipline, leur conférant crédibilité.
[16] bande passante mémoire — Le taux auquel les données peuvent être transférées entre un processeur et sa mémoire, généralement mesuré en octets ou gigaoctets par seconde. Central dans les arguments des deux côtés concernant le débit projeté de MONAKA.
[17] sous-système mémoire — L'ensemble des composants liés à la mémoire (DRAM, contrôleurs, interconnexions) qui fournissent des données à un processeur. L'affirmatif met en avant le sous-système mémoire à haute bande passante de MONAKA comme un choix de conception clé.
[18] multi-locataire — environnement multi-locataires — Un environnement informatique où plusieurs utilisateurs ou charges de travail indépendants partagent le même matériel. Le négatif soutient que les conditions multi-locataires réelles compliquent la relation bande passante-débit.
[19] NEXT — Effort de développement post-exascale NEXT — Le programme financé par l'État japonais pour le développement informatique au-delà du niveau exascale, cité dans le débat comme étant le programme sous lequel les spécifications de MONAKA ont été publiées.
[20] non-linéarités — Déviations par rapport à une relation proportionnelle (linéaire) entre deux variables. Le négatif soutient que le ratio compute-à-bande passante présente des non-linéarités qui empêchent de simples ratios de bande passante de se traduire en ratios de débit.
[21] par paquet — Mesuré au niveau d'un seul socket CPU, plutôt que par cœur ou par système. L'affirmatif définit 'débit d'inférence IA 2x' comme étant mesuré par paquet.
[22] débit par cœur de matrice — Le taux auquel un seul cœur de traitement peut exécuter des opérations matricielles, pertinent pour l'inférence IA. Le négatif conteste l'enveloppe plausible de l'objectif 2x basé sur l'arithmétique de la bande passante mémoire et du débit par cœur.
[23] post-exascale — Calcul post-exascale — Objectifs de performance de calcul au-delà du seuil exascale. Le programme NEXT du Japon est décrit comme un 'effort de développement post-exascale.'
[24] orientation de la feuille de route — Déclarations prospectives d'une entreprise concernant les spécifications de produits planifiés et les dates de livraison. L'affirmatif considère que les spécifications publiées de MONAKA par Fujitsu constituent une orientation de la feuille de route d'un émetteur de grande-cap avec un historique de livraison.
[25] CPU expédié — Un CPU qui est commercialement disponible et livré aux clients, par opposition à celui qui est annoncé ou en développement. L'affirmatif définit la comparaison 2x par rapport au 'meilleur CPU expédié de la même période.'
[26] fallacy de substitution — Erreur de logique de substitution d'entités — Une erreur logique où une propriété mesurée pour une entité est transférée à une autre entité sans justification. Le négatif accuse l'affirmatif de substituer une mesure du sous-système mémoire à une conclusion sur le débit du processeur.
[27] SVE2 — Extension vectorielle évolutive version 2 — Une extension de l'ensemble d'instructions ARM fournissant des opérations vectorielles SIMD évolutives et des opérations matricielles. L'affirmatif cite la 'capacité vectorielle/matricielle de classe SVE2' de MONAKA comme faisant partie de ses spécifications divulguées.
[28] débit — Le taux auquel le travail est accompli par unité de temps. Dans le débat, 'débit d'inférence IA' fait référence au volume de travail d'inférence qu'un CPU peut effectuer, mesuré par paquet sur des charges de travail de style commercial.
[29] opérateur de transfert — Une relation ou un coefficient quantifié qui relie une mesure d'une variable (par exemple, bande passante mémoire) à une autre (par exemple, débit d'inférence de bout en bout). Le négatif soutient que l'affirmatif ne fournit pas un tel opérateur.
[30] capacité vectorielle/matricielle — Capacité de traitement vectoriel et matriciel — Support matériel pour les opérations vectorielles de style SIMD et l'arithmétique matricielle, qui sont au cœur de la performance d'inférence IA. MONAKA est décrit comme disposant d'une capacité vectorielle/matricielle de classe SVE2.
Les tableaux de données financières suivants ont été référencés lors des échanges du débat :
| Processeur (fournisseur) | Cœurs (max annoncé) |
|---|---|
| NVIDIA Grace | 72 |
| Fujitsu MONAKA | 144 |
| Intel Xeon 6 | 128 |
| AMD EPYC 9005 | 128 |
| Ampere One | 192 |
Légende : Nombre maximum de cœurs annoncés par paquet CPU pour les principaux processeurs serveurs disponibles commercialement versus Fujitsu's MONAKA (objectif de conception Armv9 à 144 cœurs). Unités : cœurs par paquet. Source : divulgations de produits des fournisseurs et annonces publiques d’architecture (fenêtre 2024–2026).
| Attribut | CPU de référence en production | Objectif Fujitsu MONAKA |
|---|---|---|
| Attachement mémoire | DDR5 multi-canaux par socket (~0,5–0,9 To/s) | HBM-class sur le package (≥1 To/s) |
| ISA vector/matrice | Armv8/v9 SVE, unités de classe x86 AMX | Armv9 SVE2 + chemin de données orienté IA/matrice |
| Intention de conception | Calcul à usage général | Inférence IA + HPC, CPU pour nœud exascale |
| Intégration | Socket CPU + accélérateurs discrets | Pack CPU co-conçu avec tissu d’accélérateurs |
Légende : Comparaison au niveau architecture de la contrainte limitant la bande passante pour l’inférence LLM liée à la bande passante. Les chiffres de bande passante sont des plages de référence déclarées pour sockets DDR5 à 8–12 canaux versus des stacks de classe HBM3 (un seul stack HBM3 de 1024 bits atteint environ 0,8 To/s, donc deux stacks dépassent 1,5 To/s). Benchmarks non mesurés ; classes de spécifications uniquement.
- ■
Propriété & Secrets commerciaux. La société Lambda Vision conserve tous les droits sur sa plateforme, ses flux de travail agentiques et ses méthodologies financières propriétaires, qui constituent des Secrets commerciaux protégés (Directive UE 2016/943). Sous réserve du paiement intégral des crédits, l’Utilisateur se voit accorder la propriété des Rapports générés pour son usage professionnel personnel. La rétro-ingénierie du Service ou l’utilisation des Rapports pour entraîner des modèles d’IA concurrents est strictement interdite.
- ■
Aucun conseil financier. Le Service et les Rapports sont fournis à titre informatif uniquement et ne constituent pas un conseil financier, d’investissement, juridique ou fiscal. La société n’est pas un conseiller financier réglementé. Les résultats générés par IA peuvent contenir des erreurs ; l’Utilisateur est seul responsable de la vérification des données et assume tous les risques liés à toute décision ou perte financière.
- ■
Responsabilité & Loi applicable. Dans la mesure maximale permise par la loi, la société ne pourra être tenue responsable de tout dommage indirect ou financier. Ces Conditions sont régies par la loi française. Tout litige sera soumis à la compétence exclusive des tribunaux de Paris, France.