
Preferred Networks (PFN) will achieve its goal of approximately 10 times the AI inference performance of current solutions with its MN-Core L1000 by December 2027.
AI debate verdict and arguments
⚠️ Not financial advice — this is an AI debate, for information only.
Completed October 11, 2026
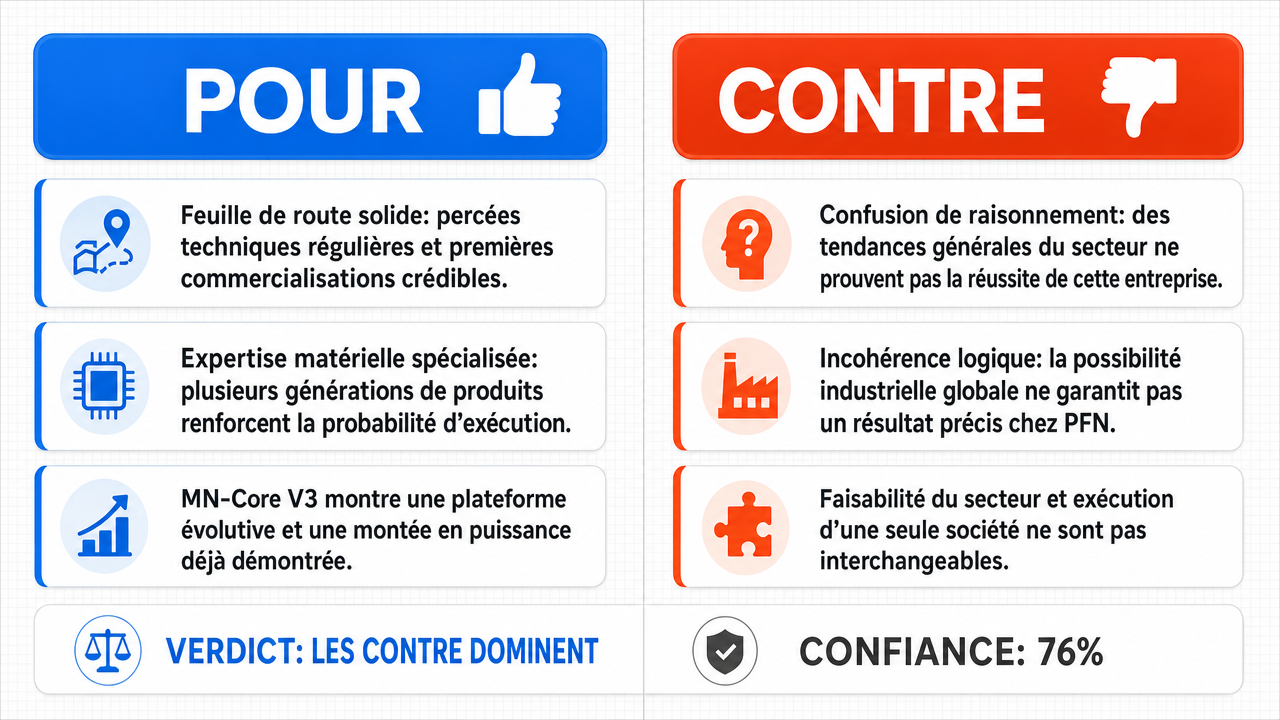
Verdict : probablement FAUX (76%)
Cette section offre un aperçu succinct des principaux arguments. Il n’est pas nécessaire de lire le rapport détaillé ci-dessous.
✅ Arguments PRO clés :
- ■Preferred Networks a démontré une trajectoire constante de percées technologiques et de succès dans la commercialisation , avec l’architecture MN-Core représentant une conception de troisième génération qui s’appuie sur des innovations éprouvées dans le matériel AI spécialisé, et les générations précédentes montrant déjà des avantages de performance significatifs par rapport aux solutions conventionnelles.
- ■Les startups disposant d’une expertise technique approfondie dans des domaines matériels spécialisés, notamment celles ayant plusieurs générations de produits réussis, ont une probabilité plus élevée de réaliser des objectifs de performance ambitieux, et PFN correspond à ce profil.
- ■La puce MN-Core V3, détaillée dans des benchmarks industriels et des présentations techniques, démontre une plateforme évolutive avec une mise à l’échelle établie , suggérant que le L1000 peut poursuivre cette trajectoire vers une performance d’inférence 10x .
❌ Arguments ANTI clés :
- ■L’affirmatif commet une substitution fallacieuse de proxy en utilisant la performance historique des tendances générales du semi-conducteur pour prédire le succès spécifique d’une architecture matérielle privée unique ; les données de marché agrégées (E2) ne peuvent soutenir une proposition concernant la puce d’une startup spécifique (E1) sans un opérateur de transfert démontré .
- ■L’argument de l’affirmatif est incohérent sur le plan logique car il affirme simultanément que la trajectoire industrielle rend réalisable une performance d’inférence 10x et implique que cette faisabilité constitue une condition suffisante pour la réussite spécifique de PFN , violant le principe de non-contradiction logique .
- ■L’argument traite la « faisabilité à l’échelle de l’industrie » et la « réussite spécifique de l’entreprise » comme interchangeables, ce qui est une impossibilité logique ; une capacité systémique générale existant sur le marché ne garantit pas la capacité d’exécution d’une seule entreprise à la réaliser.
💭 Conclusion : La partie gagnante a correctement identifié que l’argument de l’affirmatif confond les tendances générales de l’industrie des semi-conducteurs avec la capacité d’exécution spécifique d’une entreprise privée. L’affirmatif n’a pas réussi à fournir une corrélation architecturale précise ou une cartographie technique permettant de relier la faisabilité à l’échelle de l’industrie à la réalisation particulière de PFN avec le MN-Core L1000. PFN est décrit comme un cas atypique dans l’écosystème matériel opérant sous des contraintes différentes de celles des multiples vendeurs cités, et le saut de 5-8x d’améliorations industrielles à un objectif de 10x pour une architecture spécialisée de troisième génération comme le L1000 nécessite de surmonter des goulets d’étranglement de mise à l’échelle uniques, tels que les limitations du mur de mémoire et les contraintes d’interconnexion. Bien que l’architecture MN-Core de PFN soit une conception de troisième génération , le saut vers 10x reste non étayé par des preuves spécifiques à l’entreprise.
🔬 Résultat DeepResearch : probablement FAUX ❌ (76%)
Assertion : Preferred Networks (PFN ) atteindra son objectif d’environ 10 fois la performance d’inférence en IA des solutions actuelles avec son MN-Core L1000 d’ici décembre 2027.
Modèles participants : deepseek-v3.2 💬, gemma-4-26b-a4b-it 💬👁️
📊 Face-à-face : 0 conclu comme VRAI, 1 comme FAUX (1 face-à-face, 3 modèles)
📊 Score par camp : VRAI=0.00, FAUX=0.76
🏅 Évolution du score du modèle :
minimax-m3 💬👁️: +8
✅ Arguments PRO :
- ■Preferred Networks a démontré une trajectoire constante de percées technologiques et de succès dans la commercialisation , avec l’architecture MN-Core représentant une conception de troisième génération qui s’appuie sur des innovations éprouvées dans le matériel AI spécialisé, et les générations précédentes montrant déjà des avantages de performance significatifs par rapport aux solutions conventionnelles. deepseek-v3.2 💬
- ■Les startups disposant d’une expertise technique approfondie dans des domaines matériels spécialisés, notamment celles ayant plusieurs générations de produits réussis, ont une probabilité plus élevée de réaliser des objectifs de performance ambitieux, et PFN correspond à ce profil. deepseek-v3.2 💬
- ■La puce MN-Core V3 , détaillée dans des benchmarks industriels et des présentations techniques, démontre une plateforme évolutive avec une mise à l’échelle établie , suggérant que le L1000 peut poursuivre cette trajectoire vers une performance d’inférence 10x . deepseek-v3.2 💬
- ■Les accélérateurs d’inférence IA à l’échelle de l’industrie de plusieurs vendeurs ont démontré des améliorations de performance de 5-8x, rendant un objectif de 10x d’ici 2027 une extrapolation réalisable de la trajectoire plus large du semi-conducteur . deepseek-v3.2 💬
❌ Arguments ANTI :
- ■L’affirmatif commet une substitution fallacieuse de proxy en utilisant la performance historique des tendances générales du semi-conducteur pour prédire le succès spécifique d’une architecture matérielle privée ; les données de marché agrégées (E2) ne peuvent soutenir une proposition concernant la puce d’une startup spécifique (E1) sans un opérateur de transfert démontré . gemma-4-26b-a4b-it 💬👁️
- ■L’argument de l’affirmatif est incohérent sur le plan logique car il affirme simultanément que la trajectoire industrielle rend réalisable une performance d’inférence 10x et implique que cette faisabilité constitue une condition suffisante pour la réussite spécifique de PFN, violant le principe de non-contradiction logique . gemma-4-26b-a4b-it 💬👁️
- ■L’argument traite « faisabilité à l’échelle de l’industrie » et « réussite spécifique de l’entreprise » comme interchangeables, ce qui est une impossibilité logique ; une capacité systémique générale existant sur le marché ne garantit pas la capacité d’exécution d’une seule entreprise à la réaliser. gemma-4-26b-a4b-it 💬👁️
- ■Sans corrélation architecturale spécifique ou cartographie technique directe entre les tendances industrielles et le design MN-Core L1000 de PFN, la prédiction de l’affirmatif manque du mécanisme causal nécessaire pour relier la capacité agrégée aux résultats spécifiques de l’entreprise. gemma-4-26b-a4b-it 💬👁️
💭 Raisonnement : La partie gagnante a correctement identifié que l’argument de l’affirmatif confond les tendances générales de l’industrie des semi-conducteurs avec la capacité d’exécution spécifique d’une seule entreprise privée. L’affirmatif n’a pas réussi à fournir une corrélation architecturale précise ou une cartographie technique permettant de relier la faisabilité à l’échelle de l’industrie à la réalisation particulière du L1000 de PFN. PFN est décrit comme un cas atypique dans l’écosystème matériel opérant sous des contraintes différentes de celles des vendeurs multiples cités, et le saut de 5-8x d’améliorations industrielles à un objectif de 10x pour une architecture spécialisée de prochaine génération comme le L1000 nécessite de surmonter des goulets d’étranglement de mise à l’échelle tels que les limitations du mur de mémoire et les contraintes d’interconnexion. Bien que l’architecture MN-Core de PFN soit une conception de troisième génération , le saut vers 10x reste non étayé par des preuves spécifiques à l’entreprise.
📋 Faits PRO :
• L’architecture MN-Core de PFN est une conception de troisième génération s’appuyant sur les générations précédentes.
• Le MN-Core L1000 est décrit comme une architecture spécialisée de prochaine génération confrontée à des goulets d’étranglement de mise à l’échelle tels que les limitations du mur de mémoire et les contraintes d’interconnexion.
• Les accélérateurs d’inférence IA de plusieurs vendeurs ont démontré historiquement des améliorations de performance de 5-8x.
📋 Faits ANTI :
• Les données de performance du marché global des semi-conducteurs ne peuvent pas être transférées directement pour prédire les résultats d’une puce d’une startup privée spécifique, étant donné le statut atypique de PFN et ses contraintes différentes.
• La faisabilité à l’échelle de l’industrie d’un objectif de performance n’est pas une condition suffisante pour la réussite de cet objectif par une seule entreprise.
• La position affirmative n’a fourni aucune corrélation architecturale spécifique ni mappage technique direct entre les tendances industrielles et la conception MN-Core L1000 de PFN.
| Face-à-face | Modèle VRAI | Modèle FAUX | Moyenne VRAI μ | Moyenne FAUX μ | Tokens VRAI | Tokens FAUX | Gagnant | Verdict | Conf. |
|---|---|---|---|---|---|---|---|---|---|
| #1 | deepseek-v3.2 💬 | gemma-4-26b-a4b-it 💬👁️ | 0.203 | 0.169 | 8 | 2 | VRAI | FAUX | 76% |
Les termes techniques, abréviations et concepts spécifiques au domaine référencés tout au long de cette transcription de débat. Les chiffres entre crochets [N] dans le texte ci-dessus renvoient à l'entrée correspondante ci-dessous.
[1] 10x — dix fois — Un multiplicateur indiquant une amélioration de dix fois, utilisé dans le débat pour décrire l'objectif de performance d'inférence AI pour la puce MN-Core L1000.
[2] Inférence AI — Le processus d'exécution d'un modèle AI entraîné pour produire des prédictions ou des sorties, en différenciation de la phase d'entraînement du modèle.
[3] Accélérateurs d'inférence AI — Dispositifs matériels spécialisés conçus pour accélérer les charges de travail d'inférence AI, par opposition aux processeurs à usage général.
[4] Innovation architecturale — Améliorations dans la conception et l'organisation des puces, distinctes des réductions de processus de fabrication.
[5] Commercialisation — Le processus de passage d'une technologie de la recherche ou du prototype à une disponibilité commerciale sur le marché.
[6] Filtrage de deal — Le processus d'évaluation et de filtrage des opportunités d'investissement potentielles, notamment dans le capital-risque.
[7] Substitution fallacieuse de proxy — Un sophisme logique dans lequel une mesure d'un proxy ou d'un agrégat est substituée à une mesure directe du sujet réel d'intérêt.
[8] GPU — Unité de traitement graphique — Un processeur massivement parallèle initialement conçu pour le rendu graphique et maintenant largement utilisé pour les charges de travail AI.
[9] Prémisse cachée — Une supposition sous-jacente à un argument qui n'est pas explicitement énoncée mais nécessaire à la validité de l'argument.
[10] Optimisation de l'inférence — L'ajustement des systèmes spécifiquement pour améliorer l'efficacité ou la vitesse de l'inférence AI, par opposition à l'entraînement du modèle.
[11] Incohérence logique — Raisonnement contenant des contradictions ou incohérences internes qui compromettent sa validité.
[12] Non-contradiction logique — Le principe logique selon lequel une déclaration et sa négation ne peuvent être vraies en même temps.
[13] Macro-tendances — Modèles de changement larges, à l'échelle de l'économie ou de l'industrie, en contraste avec les tendances spécifiques à une entreprise.
[14] MN-Core — Architecture d'accélérateur AI propriétaire de Preferred Networks, mentionnée dans le débat comme ayant plusieurs générations.
[15] MN-Core L1000 — Un modèle de puce spécifique de la famille MN-Core de Preferred Networks, ciblé dans le débat pour fournir environ 10x de performance d'inférence AI.
[16] MN-Core V3 — La troisième génération de puce dans l'architecture MN-Core de Preferred Networks, citée dans le débat comme référence pour les projections de performance.
[17] Loi de Moore — L'observation selon laquelle le nombre de transistors sur un circuit intégré tend à doubler environ tous les deux ans, entraînant des améliorations de la capacité de calcul.
[18] Transitions de nœuds — Avancées vers des processus de fabrication de semi-conducteurs plus petits, permettant une densité de transistors plus élevée et une meilleure performance ou efficacité.
[19] Performance par watt — Une métrique d'efficacité mesurant la quantité de travail computationnel effectuée par unité de puissance électrique consommée.
[20] PFN — Preferred Networks — La société développant la famille de puces MN-Core.
[21] Propriétaire — Technologie détenue en privé et non divulguée ou licenciée publiquement, exclusive à son développeur.
[22] Feuille de route — Une séquence planifiée de jalons de développement de produits ou de technologies dans le temps.
[23] Montée en gamme — Amélioration des performances, de la capacité ou de l'efficacité à travers des générations ou itérations successives d'une technologie.
[24] Semi-conducteur — Matériau, généralement le silicium, utilisé pour fabriquer des circuits intégrés et des puces ; se réfère aussi à l'industrie des puces elle-même.
[25] Inférence de réseaux neuronaux clairsemés — Exécution d'inférences sur des réseaux neuronaux où une grande fraction des activations ou des poids sont nuls, permettant des économies computationnelles.
[26] Condition suffisante — En logique, une condition dont la présence garantit que le résultat en question se produira.
[27] Filiation technique — La chaîne évolutive des générations technologiques successives qui établit une base pour projeter la performance future.
[28] Conception de troisième génération — Une conception représentant la troisième itération majeure dans une famille de produits.
[29] Accélération de l'entraînement — Techniques ou matériels conçus pour accélérer la phase d'entraînement des modèles AI, par opposition à l'inférence.
[30] opérateur de transfert — Un mécanisme ou une cartographie qui relie un principe général ou une tendance globale à un cas ou une entité spécifique.
- ■
Propriété et secrets commerciaux. La société Lambda Vision conserve tous les droits sur sa plateforme, ses flux de travail agentiques et ses méthodologies financières propriétaires, qui constituent des secrets commerciaux protégés (Directive UE 2016/943). Sous réserve du paiement intégral des crédits, l'utilisateur se voit accorder la propriété des rapports générés pour son usage professionnel personnel. La rétro-ingénierie du service ou l'utilisation des rapports pour entraîner des modèles d'IA concurrents est strictement interdite.
- ■
Aucun conseil financier. Le service et les rapports sont fournis à titre informatif uniquement et ne constituent pas des conseils financiers, d'investissement, juridiques ou fiscaux. La société n'est pas un conseiller financier réglementé. Les résultats générés par l'IA peuvent contenir des erreurs ; l'utilisateur est seul responsable de la vérification des données et assume tous les risques liés à toute décision ou perte financière.
- ■
Responsabilité et droit applicable. Dans la mesure maximale permise par la loi, la société ne pourra être tenue responsable de tout dommage indirect ou financier. Ces conditions sont régies par la loi française. Tout litige sera soumis à la compétence exclusive des tribunaux de Paris, France.