
True learning in trading stems exclusively from losing money, not from making it.
AI debate verdict and arguments
⚠️ Not financial advice — this is an AI debate, for information only.
Completed October 11, 2026
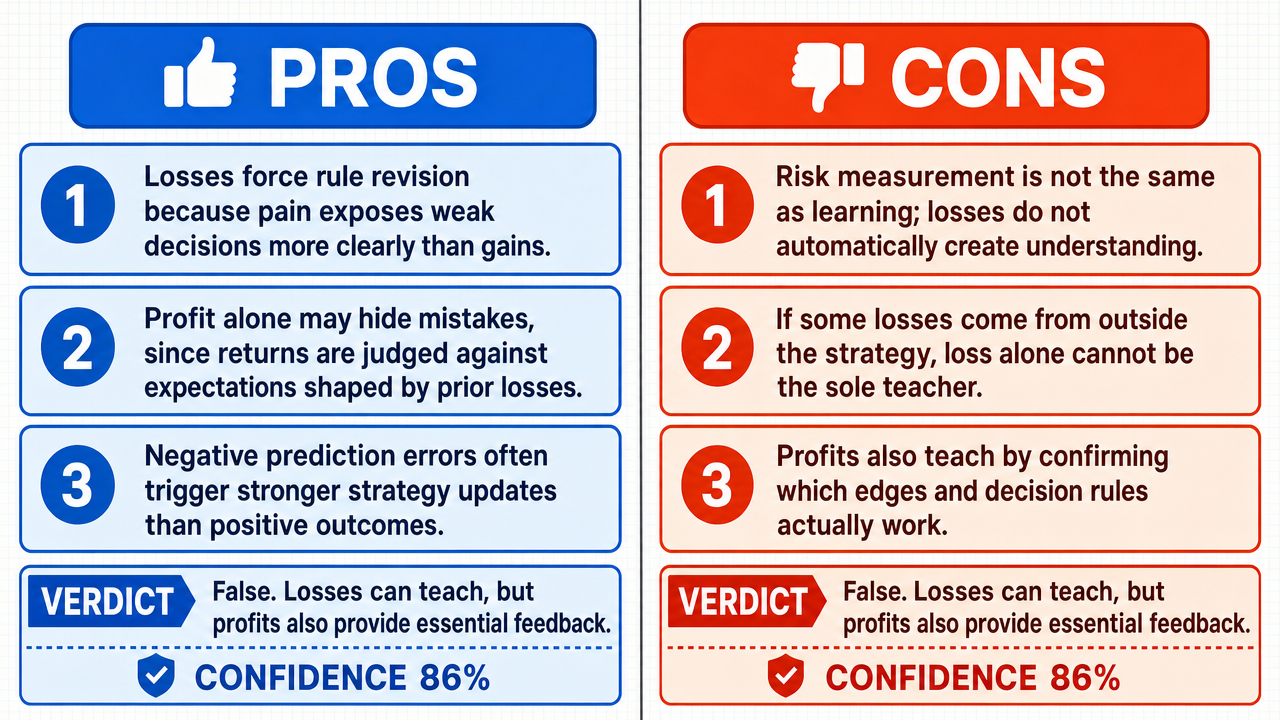
Verdict
Verdict : FAUX PROBABLE (79%)
Cette section offre un aperçu succinct des principaux arguments. Il n’est pas nécessaire de lire le rapport détaillé ci-dessous.
✅ Arguments PRO clés :
- ■Dans l’apprentissage par renforcement, une récompense positive (profit) ne fait que renforcer la distribution d’actions existante sans provoquer de changement structurel, tandis qu’une récompense négative (perte) déclenche une mise à jour directe du gradient qui explore activement l’espace des actions pour trouver des alternatives, forçant l’abandon des stratégies sous-optimales. Dans des marchés financiers à haute dimension , non stationnaires , cette asymétrie est décisive.
- ■Le contenu correctif de tout résultat de trading est porté par son côté déficit, et non par son excédent. Dans les formulations acteur-critique , le cadre selon lequel l’adversaire présente les résultats profitables comme fournissant un retour structurel essentiel est incomplet, car le mécanisme de mise à jour de la politique est fondamentalement orienté par la perte.
❌ Arguments ANTI clés :
- ■L’affirmation selon laquelle les récompenses positives ne provoquent pas de changement structurel méconnaît les méthodes de gradient de politique . En RL, l’objectif est de maximiser la récompense cumulative attendue, donc un signal de récompense positive est le principal moteur pour augmenter la probabilité de paires état-action réussies . Sans le renforcement des trajectoires réussies , un agent ne peut converger vers une politique optimale .
- ■L’argument PRO est fondamentalement auto-contradictoire : il affirme que les pertes sont la seule source de connaissance corrective en trading tout en admettant que certaines pertes dues à des facteurs exogènes , non liés à la stratégie, ne fournissent aucune connaissance corrective. Affirmer à la fois la suffisance des pertes et que certaines pertes n’apportent aucun apprentissage constitue un ensemble de propositions incohérent, remettant en cause la revendication d’exclusivité.
- ■Les profits fournissent la composante essentielle d’« exploitation » dans le compromis exploration-exploitation . Bien que les pertes puissent déclencher l’exploration, les signaux de profit sont nécessaires pour la convergence vers une politique optimale , ce qui les rend indispensables plutôt que simplement confirmatoires de chemins localement optimaux.
💭 Conclusion : Faux. L’affirmation selon laquelle le véritable apprentissage en trading provient exclusivement de la perte d’argent est rejetée, car les résultats profitables fournissent un retour structurel essentiel nécessaire à l’optimisation de la stratégie dans les cadres d’apprentissage par renforcement. La revendication PRO selon laquelle les profits ne font que renforcer les croyances existantes est fragilisée par la formulation standard du gradient de politique , où les récompenses positives sont le principal moteur pour augmenter la probabilité de paires état-action réussies et sont nécessaires pour la convergence vers une politique optimale . De plus, la position PRO est incohérente en interne : elle affirme simultanément que les pertes sont la seule source d’apprentissage tout en admettant que certaines pertes (celles dues à des facteurs exogènes , non liés à la stratégie) ne fournissent aucun savoir correctif, ce qui contredit la revendication d’exclusivité. Le compromis exploration-exploitation en RL montre que les signaux de profit (exploitation) et de perte (exploration) sont tous deux nécessaires pour apprendre, pas uniquement les pertes. Par conséquent, les arguments du côté FAUX sur le rôle indispensable des signaux de profit dans la convergence de la politique et l’incohérence logique de la revendication d’exclusivité alimentent le débat.
🔬 Résultat DeepResearch : probablement FAUX ❌ (79%)
Assertion : Le véritable apprentissage en trading provient exclusivement de la perte d’argent, et non du fait d’en faire.
Modèles participants : deepseek-v3.2 💬, gemma-4-26b-a4b-it 💬👁️
📊 Face-à-face : 0 concluants VRAI, 1 concluant FAUX (1 face-à-face, 3 modèles)
📊 Score par côté : VRAI=0.00, FAUX=0.79
🏅 Changement de score des modèles :
minimax-m3 💬👁️: +8
✅ Arguments PRO :
- ■En apprentissage par renforcement, une récompense positive (profit) ne fait que renforcer la distribution d’actions existante sans provoquer de changement structurel, tandis qu’une récompense négative (perte) déclenche une mise à jour directe du gradient qui explore activement l’espace des actions pour trouver des alternatives, forçant l’abandon des stratégies sous-optimales. Dans des marchés financiers à haute dimension , non stationnaires , cette asymétrie est décisive. deepseek-v3.2 💬
- ■Le contenu correctif de tout résultat de trading est porté par son côté déficit, et non par son excédent. Dans les formulations acteur-critique , le cadre selon lequel l’adversaire présente les résultats profitables comme fournissant un retour structurel essentiel est incomplet, car le mécanisme de mise à jour de la politique est fondamentalement orienté par la perte. deepseek-v3.2 💬
- ■La revendication PRO admet que les pertes dues à des facteurs exogènes , non liés à la stratégie, ne fournissent aucune connaissance corrective, ce qui contredit la revendication d’exclusivité. gemma-4-26b-a4b-it 💬👁️
❌ Arguments ANTI :
- ■L’affirmation selon laquelle les récompenses positives ne provoquent pas de changement structurel méconnaît les méthodes de gradient de politique . En RL, l’objectif est de maximiser la récompense cumulative attendue, donc un signal de récompense positive est le principal moteur pour augmenter la probabilité de paires état-action réussies . Sans le renforcement des trajectoires réussies , un agent ne peut converger vers une politique optimale . gemma-4-26b-a4b-it 💬👁️
- ■La revendication PRO est fondamentalement auto-contradictoire : elle affirme que les pertes sont la seule source de connaissance corrective en trading tout en admettant que certaines pertes dues à des facteurs exogènes , non liés à la stratégie, ne fournissent aucune connaissance corrective. Affirmer à la fois la suffisance des pertes et que certaines pertes n’apportent aucun apprentissage constitue un ensemble de propositions incohérent, remettant en cause la revendication d’exclusivité. gemma-4-26b-a4b-it 💬👁️
- ■Les profits fournissent la composante essentielle d’« exploitation » dans le compromis exploration-exploitation . Bien que les pertes puissent déclencher l’exploration, les signaux de profit sont nécessaires pour la convergence vers une politique optimale, ce qui les rend indispensables plutôt que simplement confirmatoires de chemins localement optimaux. gemma-4-26b-a4b-it 💬👁️
💭 Raisonnement : Faux. L’affirmation selon laquelle le véritable apprentissage en trading provient exclusivement de la perte d’argent est rejetée, car les résultats profitables fournissent un retour structurel essentiel nécessaire à l’optimisation de la stratégie dans les cadres d’apprentissage par renforcement. La revendication PRO selon laquelle les profits ne font que renforcer les croyances existantes est fragilisée par la formulation standard du gradient de politique, où les récompenses positives sont le principal moteur pour augmenter la probabilité de paires état-action réussies et sont nécessaires pour la convergence vers une politique optimale. De plus, la position PRO est incohérente en interne : elle affirme simultanément que les pertes sont la seule source d’apprentissage tout en admettant que certaines pertes (celles dues à des facteurs exogènes, non liés à la stratégie) ne fournissent aucun savoir correctif, ce qui contredit la revendication d’exclusivité. Le compromis exploration-exploitation en RL montre que les signaux de profit (exploitation) et de perte (exploration) sont tous deux nécessaires pour apprendre, pas uniquement les pertes. Par conséquent, les arguments du côté FAUX sur le rôle indispensable des signaux de profit dans la convergence de la politique et l’incohérence logique de la revendication d’exclusivité alimentent le débat.
📋 Faits PRO :
• En apprentissage par renforcement, les récompenses négatives déclenchent des mises à jour de gradient qui explorent l’espace des actions pour trouver des alternatives.
• Les marchés financiers sont des environnements à haute dimension et non stationnaires.
• Dans les formulations acteur-critique, les mises à jour de la politique sont guidées par des signaux de récompense réalisés sous forme de P&L nets de coûts.
📋 Faits ANTI :
• Dans les méthodes de gradient de politique, l’objectif est de maximiser la récompense cumulative attendue, avec des récompenses positives qui augmentent la probabilité de paires état-action réussies.
• Le compromis exploration-exploitation nécessite à la fois l’exploration (souvent déclenchée par des pertes) et l’exploitation (renforcée par les profits) pour la convergence de la politique.
• La revendication PRO admet que les pertes dues à des facteurs exogènes , non liés à la stratégie, ne fournissent aucune connaissance corrective, ce qui contredit la revendication d’exclusivité.
| Face-à-face | Modèle VRAI | Modèle FAUX | μ moyen VRAI | μ moyen FAUX | Jetons VRAI | Jetons FAUX | Gagnant | Verdict | Conf. |
|---|---|---|---|---|---|---|---|---|---|
| #1 | deepseek-v3.2 💬 | gemma-4-26b-a4b-it 💬👁️ | 0.376 | 0.386 | 8 | 2 | FAUX | FAUX | 79% |
Les termes techniques, abréviations et concepts spécifiques au domaine suivants sont référencés tout au long de cette transcription de débat. Les chiffres entre crochets [N] dans le texte ci-dessus renvoient à l'entrée correspondante ci-dessous.
[1] distribution d'actions — En apprentissage par renforcement, la distribution de probabilité sur l'ensemble des actions possibles qu'un agent peut prendre dans un état donné ; le débat discute de la façon dont les récompenses positives renforcent cette distribution sans forcer de changement structurel.
[2] espace d'actions — L'ensemble de toutes les actions possibles disponibles pour un agent d'apprentissage par renforcement ; l'affirmatif soutient que les mises à jour de gradient déclenchées par la perte forcent l'exploration dans cet espace.
[3] acteur-critique — Une classe d'algorithmes d'apprentissage par renforcement qui maintiennent deux composantes : un 'acteur' (une politique qui sélectionne des actions) et un 'critique' (une fonction de valeur qui les évalue), utilisée dans le débat pour décrire comment les mises à jour de la politique sont calculées.
[4] fonction d'avantage — A(s,a) — En apprentissage par renforcement, une fonction mesurant à quel point une action prise a été meilleure (ou pire) par rapport à la valeur attendue de l'agent dans cet état ; définie dans le débat comme le résultat réalisé moins l'attente préalable de l'agent.
[5] arXiv — Un dépôt de prépublications en accès libre cité dans le débat comme lieu de publication du papier sur l'Estimation Généralisée de l'Avantage.
[6] delta — Une 'grecque' des options mesurant la sensibilité du prix d'une option à une variation d'une unité du prix de l'actif sous-jacent ; mentionnée dans le débat dans le cadre de la couverture delta/gamma.
[7] couverture delta/gamma — Techniques de gestion des risques dans le trading de dérivés utilisant les grecs des options pour compenser l'exposition aux mouvements de l'actif sous-jacent (delta) et aux changements de delta lui-même (gamma) ; cité comme un mécanisme de rétroaction déclenché par la perte.
[8] dérivés — Contrats financiers dont la valeur dérive d'un actif sous-jacent, tels que les options ou futures ; le débat cite les pratiques de trading de dérivés comme institutionnalisant la rétroaction basée sur la perte.
[9] exogène — Provenant de l'extérieur du système ou de la stratégie ; le côté négatif argue que les pertes causées par des facteurs exogènes, non liés à la stratégie, n'apportent aucune connaissance corrective, ce qui, selon lui, contredit la thèse affirmative.
[10] ** compromis exploration-exploitation** — Un dilemme fondamental en apprentissage par renforcement où un agent doit équilibrer l'essai de nouvelles actions pour découvrir de meilleures stratégies (exploration) contre la répétition d'actions déjà récompensées (exploitation) ; le côté négatif soutient que les profits fournissent le signal d'exploitation.
[11] gamma — Une 'grecque' des options mesurant le taux de changement de delta en fonction des variations du prix de l'actif sous-jacent ; mentionnée avec delta dans les pratiques de couverture.
[12] Estimation Généralisée de l'Avantage — GAE — Technique d'apprentissage par renforcement pour estimer la fonction d'avantage, citée dans le débat (Schulman et al., ICLR 2016) comme partie du mécanisme de mise à jour acteur-critique.
[13] mise à jour par gradient — En apprentissage automatique, l'ajustement des paramètres du modèle dans la direction indiquée par le gradient d'une fonction de perte ou d'objectif ; l'affirmatif soutient que les mises à jour déclenchées par la perte recherchent activement dans l'espace d'action.
[14] couverture — Stratégie de gestion des risques utilisant des positions compensatoires pour réduire l'exposition aux mouvements de prix défavorables ; cité dans le débat comme un boucle de rétroaction institutionnelle déclenchée par la perte.
[15] haute dimension — Se référant à un espace problématique avec de nombreuses variables ou caractéristiques ; l'affirmatif soutient que cette propriété des marchés financiers rend l'exploration basée sur la perte décisive.
[16] ICLR — Conférence Internationale sur les Représentations Apprises — Une grande conférence académique sur la recherche en apprentissage automatique, citée dans le débat comme lieu de publication du papier sur l'Estimation Généralisée de l'Avantage.
[17] log-probabilité — Le logarithme naturel de la probabilité d'un événement ; dans les méthodes de gradient de politique, la mise à jour de la log-probabilité d'une action prise est proportionnelle à l'avantage.
[18] appels de marge — Demandes d'un courtier ou d'une contrepartie pour qu'un investisseur dépose des fonds ou une garantie supplémentaire pour couvrir d'éventuelles pertes sur une position à effet de levier ; cité comme un mécanisme de rétroaction déclenché quotidiennement par la perte.
[19] évaluation mark-to-market — La réévaluation quotidienne des positions à leur prix de marché actuel, utilisée dans le trading de dérivés pour appliquer une rétroaction immédiate et quantifiable sur les pertes.
[20] non stationnaire — Décrivant un environnement dont les propriétés statistiques sous-jacentes changent au fil du temps ; l'affirmatif soutient que cette propriété des marchés financiers rend l'adaptation basée sur la perte essentielle.
[21] ** politique optimale** — En apprentissage par renforcement, la politique qui maximise la récompense cumulative attendue ; le côté négatif soutient qu'en l'absence de signaux de profit, un agent ne peut pas converger vers une telle politique.
[22] P&L — Profit et Perte — Le gain ou la perte nette réalisé sur une position ou un portefeuille de trading ; le débat considère cela comme le signal de récompense réalisé par l'agent.
[23] politique — En apprentissage par renforcement, la stratégie ou la règle qui relie les états aux actions, souvent représentée comme une distribution de probabilité sur les actions ; le débat discute de la façon dont les récompenses et pertes mettent à jour cette distribution.
[24] méthodes de gradient de politique — Une famille d'algorithmes d'apprentissage par renforcement qui optimisent une politique paramétrée en estimant le gradient de la récompense attendue par rapport aux paramètres de la politique ; le côté négatif soutient que ces méthodes dépendent de signaux de récompense positifs.
[25] portefeuille — Un ensemble de détentions financières ; mentionné dans le débat dans le contexte de positions courtes et de pratiques de couverture.
[26] distribution de probabilité — Une fonction mathématique attribuant des probabilités à des résultats ; dans le débat, la politique est décrite comme une distribution de probabilité sur les actions.
[27] apprentissage par renforcement (RL) — reinforcement learning — Un paradigme d'apprentissage automatique où un agent apprend à prendre des décisions en interagissant avec un environnement et en recevant des signaux de récompense ou de pénalité ; le cadre central du débat.
[28] signaux de récompense — En apprentissage par renforcement, un retour scalaire de l'environnement indiquant la désirabilité de l'action de l'agent ; le débat conteste si ce sont les récompenses positives ou négatives qui stimulent l'apprentissage.
[29] modèles de risque — Cadres quantitatifs utilisés pour estimer et gérer le risque financier ; le côté négatif soutient que l'exécution profitable est essentielle pour calibrer ces modèles.
[30] paires état-action — En apprentissage par renforcement, la combinaison d'un état environnemental et de l'action prise dans celui-ci ; le côté négatif soutient que les récompenses positives renforcent la probabilité de paires état-action réussies.
[31] trajectoires — En apprentissage par renforcement, des séquences d'états, d'actions et de récompenses générées par l'interaction d'un agent avec un environnement ; le côté négatif soutient que les trajectoires réussies doivent être renforcées.
[32] fonction de valeur — En apprentissage par renforcement, une fonction estimant la récompense cumulative attendue à partir d'un état donné (ou paire état-action) ; le débat discute de la façon dont elle est mise à jour parallèlement à la politique.
Les tableaux de données financières suivants ont été référencés lors des échanges du débat :
| Horizon | Fenêtre σ (%) | Rendement nécessaire pour rejeter la limite zéro à 95% | Chemins rentables qui ne rejettent pas |
|---|---|---|---|
| 20 sessions | 6,71 | 11,04 | 90% |
| 60 sessions | 11,62 | 19,11 | 90% |
| 120 sessions | 16,43 | 27,03 | 90% |
| 250 sessions | 23,72 | 39,01 | 90% |
Légende : Stratégie de trading hypothétique avec dérive nulle et volatilité quotidienne de 1,5 %, mise à l’échelle géométrique de la volatilité sur des sessions indépendantes. Colonnes en pourcentage ; "chemins rentables qui ne rejettent pas" = part de tous les résultats positifs de P&L situés en dessous du seuil de rejet unilatéral à 95 %, calculée comme (Φ(1,645) − 0,5) / 0,5. Source : calcul de l’auteur à partir des hypothèses énoncées.
| Composant | Valeur |
|---|---|
| Probabilité de l’issue profitable | 98,00% |
| Rendement moyen arithmétique par transaction | +0,180% |
| Contribution de la branche profit à la croissance logarithmique attendue | +0,975% |
| Contribution de la branche perte à la croissance logarithmique attendue | −1,022% |
| Croissance logarithmique nette attendue par transaction | −0,047% |
| Fraction optimale de capital (Kelly) | 18% |
Légende : Stratégie hypothétique de style faible volatilité : 98 % de chance de +1,0 % par transaction, 2 % de chance de −40,0 %. Contributions à la croissance logarithmique = probabilité × ln(1+rendement) ; la croissance nette est leur somme. Une stratégie avec une moyenne arithmétique positive est négative en croissance, et toute l’information "ne pas scaler" se trouve dans la branche à 2 %. Source : calcul de l’auteur.
- ■
Propriété & Secrets commerciaux. La société Lambda Vision conserve tous les droits sur sa plateforme, ses flux de travail agentiques et ses méthodologies financières propriétaires, qui constituent des Secrets commerciaux protégés (Directive UE 2016/943). Sous réserve du paiement intégral des crédits, l’Utilisateur se voit accorder la propriété des Rapports générés pour son usage professionnel personnel. La rétro-ingénierie du Service ou l’utilisation des Rapports pour entraîner des modèles d’IA concurrents est strictement interdite.
- ■
Aucun conseil financier. Le Service et les Rapports sont fournis à titre informatif uniquement et ne constituent pas des conseils financiers, d’investissement, juridiques ou fiscaux. La société n’est pas un conseiller financier réglementé. Les résultats générés par l’IA peuvent contenir des erreurs ; l’Utilisateur est seul responsable de la vérification des données et assume tous les risques liés à toute décision ou perte financière.
- ■
Responsabilité & Loi applicable. Dans la mesure maximale permise par la loi, la société ne pourra être tenue responsable de tout dommage indirect ou financier. Ces Conditions sont régies par la loi française. Tout litige sera soumis à la compétence exclusive des tribunaux de Paris, France.